Solr-zoeken en meertalige content in Drupal

We gebruiken allemaal meerdere keren per dag een zoekfunctie, zonder er ooit bij stil te staan. In een webshop zoeken naar dat ene specifieke product, forums doorzoeken voor een oplossing voor je specifieke probleem, of winkels filteren op je locatie om de dichtstbijzijnde te vinden, enzovoort.

Al die voorbeelden vragen hetzelfde: content die zo geïndexeerd is dat je ze kunt filteren. Over het algemeen is dat vrij eenvoudig op te zetten: een database en een query volstaan om te beginnen.

Maar wat doe je als je bezoekers veeleisender zijn, en de juiste content verwachten wanneer ze zoeken op meervouden, combinaties van woorden of synoniemen? In de meeste gevallen gaan zulke complexe zoekopdrachten de mogelijkheden van standaardzoekoplossingen te boven, met gevreesde meldingen zoals ‘Je zoekopdracht leverde geen resultaten op’ als gevolg. Dat leidt al snel tot frustratie bij gebruikers, en daarna tot minder conversies op je website. En dat is nog maar het begin… Wat als je website ook andere Germaanse talen dan Engels bedient? Plots krijg je te maken met aaneengeschreven woorden zoals het beruchte ‘Rindfleischetikettierungsüberwachungsaufgabenübertragungsgesetz’ of ‘Chronischevermoeidheidssyndroom’.

In deze blogpost leggen we uit hoe je Apache Solr configureert om het indexeren en doorzoeken van meertalige content te verbeteren. We tonen hoe indexeren en zoeken geconfigureerd zijn en getest kunnen worden, zodat Solr je content begrijpt en betere resultaten teruggeeft wanneer gebruikers erin zoeken. We gebruiken Nederlands als voorbeeld, omwille van de complexiteit van samengestelde woorden. De onderliggende principes gelden echter voor heel wat toepassingen in andere talen en voor andere zoekproblemen.
sold multilingual

Wat zijn samengestelde woorden?

Eerst en vooral: laten we onze definities analyseren. We blijven bij het voorbeeld ‘chronischevermoeidheidssyndroom’. Dit woord bestaat uit meerdere bouwstenen: de bijvoeglijke naamwoorden ‘Chronische’ en ‘vermoeidheid’ en het zelfstandig naamwoord ‘syndroom’. In het Nederlands is het perfect aanvaardbaar om die elementen te combineren tot één lang zelfstandig naamwoord, en hetzelfde principe geldt voor het Duits. In het Engels lijkt de rechtstreekse vertaling er sterk op: ‘Chronic Fatigue Syndrome’. Het enige verschil zijn natuurlijk de handige spaties tussen de afzonderlijke onderdelen! De meeste tools voor taalverwerking splitsen woorden op spaties, waardoor je makkelijk kunt zoeken op delen van een zoekterm, omdat ze in de tekst al gesplitst staan. Bij de Duitse en Nederlandse voorbeelden hierboven is dat niet zo eenvoudig. Door die extra complexiteit moeten we onze tool voor taalverwerking zo configureren dat ze begrijpt welke samengestelde woorden mogelijk zijn en hoe ze gecombineerd worden. Gelukkig bestaan er grammaticatools die die extra complexiteit aanpakken met handige algoritmes!


Aan de slag

Eerst moeten we de nodige modules installeren:

De Search API vormt een brug tussen verschillende zoekservers, en met Search API Solr kun je communiceren met een Solr-server.

Zodra die modules geïnstalleerd zijn, is de belangrijkste voor meertalige sites de module Search API Solr Multilingual. Daarmee maak je verbinding met een Solr-server met betere ondersteuning voor andere talen dan Engels.

Gebruik je de 8.2.x-branch van Search API Solr, dan hoef je de meertalige module niet te downloaden, want die is samengevoegd met de module Search API Solr.

Zodra deze modules geïnstalleerd zijn, kun je een verbinding met een Solr-server opzetten via de Multilingual backend connector. We gaan niet dieper in op het volledige installatieproces, want de modules hebben elk hun eigen gedetailleerde installatie-instructies.

Je Solr-server configureren voor meertalige content

De meertalige Solr-module biedt ook een downloadmechanisme dat de Solr-configuratiebestanden genereert die nodig zijn om meertalige content te indexeren.

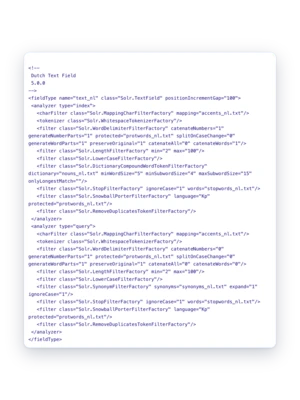
Een van de belangrijkste bestanden in deze configuratie is het bestand schema_extra_types.xml.

Dit bestand declareert een veldtype met de naam text_nl, met een aantal filters voor het indexeren van de content en een aantal voor het uitvoeren van een zoekopdracht op de index. Sommige namen spreken voor zich, bijvoorbeeld:

  • MappingCharFilterFactory: gebruikt het bestand accents_nl.txt om een bepaald teken om te zetten naar een ander. Zo kunnen we speciale tekens wegfilteren. Daardoor begrijpt het zoekmechanisme nog altijd wat je zoekt, ook als je zonder dat speciale teken zoekt.
  • CharacterWhitespaceTokenizerFactory: deze tokenizer splitst woorden op witruimte, zodat elk woord geïndexeerd wordt.
  • LengthFilterFactory: filtert woorden weg op basis van de maximum- en minimumwaarden. Voorbeeld: min=2, max=100 filtert woorden weg die korter zijn dan 2 tekens of langer dan 100 tekens.
  • LowerCaseFilterFactory: zet het token om naar kleine letters.
  • StopFilterFactory: filtert woorden weg die vermeld staan in het bestand stopwords.txt dat aan deze filter gekoppeld is. Die lijst bevat woorden zonder toegevoegde waarde, zoals bv. but, for, such, this of with.
  • SnowballPorterFilterFactory: het belangrijkste argument voor deze factory is het taalargument, want dat bepaalt hoe de stam van een woord gedefinieerd wordt. Zoals je in het voorbeeld ziet, gebruiken we Kp en niet NL voor de Nederlandse stamming. De Kp-stemmer bepaalt de stam van Nederlandse woorden namelijk beter. Meer weten over dit algoritme? Je vindt alle details via deze link.

    Kortom: door deze filter worden meervouden samen met de stam van het woord geïndexeerd. Bv. 'modules' → 'modules', 'module'
  • RemoveDuplicatesTokenFilterFactory: verwijdert dubbele tokens.

Sommige filters zijn complexer, dus die leggen we wat uitgebreider uit:

  • WordDelimiterFilterFactory: deze filter splitst woorden op basis van de argumenten.
    • CatenateNumbers: als dit niet nul is, worden getallen samengevoegd: '2018-04' → '201804'.
    • GenerateNumberParts: als dit niet nul is, worden numerieke strings gesplitst bij scheidingstekens ('2018-04' → '2018', '04'.
    • SplitOnCaseChange: als dit nul is, worden woorden niet gesplitst bij CamelCase-wissels. Voorbeeld: 'splitOnCaseChange' → 'split', 'On', 'Case', 'Change'.
    • GenerateWordParts: als dit niet nul is, worden woorden gesplitst bij scheidingstekens. 'DrupalCon' → 'Drupal', 'Con'.
    • PreserveOriginal: als dit niet nul is, blijft het originele woord behouden. 'DrupalCon' → 'DrupalCon', 'Drupal', 'Con'.
    • CatenateAll: als dit niet nul is, worden woorden en getallen samengevoegd. 'DrupalCon-2018' → 'DrupalCon2018'
    • CatenateWords: als dit niet nul is, worden woorddelen samengevoegd: 'high-resolution-image' → 'highresolutionimage'
    • Protected: het pad naar een bestand met een lijst van woorden die niet gesplitst mogen worden.
  • DictionaryCompoundWordTokenFilterFactory: deze filter splitst samengestelde woorden in afzonderlijke woorden, op basis van de woordenlijst die als dictionary-argument meegegeven wordt. Voorbeeld: 'flagpole' → 'flag', 'pole'
  • SynonymFilterFactory: met deze filter kun je woorden als synoniemen definiëren, door een lijst met synoniemen mee te geven als synonyms-argument. Die lijst is een kommagescheiden lijst van woorden die synoniemen zijn. Je kunt ze ook gebruiken om spelfouten op te vangen.
    • Voorbeeld: drupal, durpal zorgt ervoor dat wanneer een gebruiker zoekt op durpal, resultaten met drupal in de index als mogelijke match getoond worden.

Met deze opzet maak je het indexeren en doorzoeken van je content een stuk slimmer. Je vindt verschillende bestanden synonyms.txt, nouns.txt en accent.txt als je online zoekt voor jouw taal.


Waar vind ik deze txt-bestanden?

Herinner je je het stuk over samengestelde woorden? Hier komt die kennis van pas. We zochten lang online naar een goede lijst met samengestelde woorden en stopwoorden. Om je het leven makkelijker te maken, voegden we ze aan deze blogpost toe als GitLab-links, die je kunt bekijken, bewerken en waaraan je kunt bijdragen. Deze bestanden zijn voor Solr-versie 5 en hoger, en voor het Nederlands, Engels en Frans.

Let wel op! Als je deze bestanden aan een bestaande index toevoegt, moet je een meertalige serververbinding gebruiken en je data daarna opnieuw indexeren. Doe je dat niet, dan lopen je index en je zoekopdracht niet langer gelijk, en dat kan zelfs een negatieve impact hebben op je omgeving.

Geïndexeerde resultaten en zoekresultaten testen

Heb je een Solr-server en -core geïnstalleerd, dan kun je het Solr-dashboard bezoeken. Standaard bereik je dat via localhost:8983/

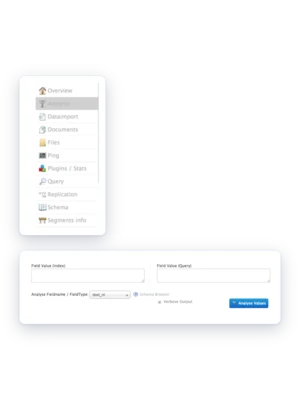
Selecteer je core, dan kun je naar het tabblad Analysis gaan.

Op dit scherm kun je een zoekopdracht uitvoeren, en zien hoe de index (linkerveld) of de zoekopdracht (rechterveld) je waarde verwerkt. Het is belangrijk om het veldtype te selecteren, zodat de analyse weet welke filters ze op je waarde moet toepassen.

Wat je beter vermijdt

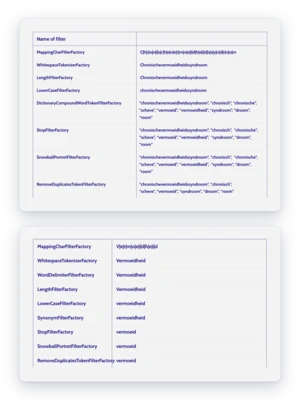
We blijven bij ons voorbeeld van het Nederlandse woord ‘Chronischevermoeidheidssyndroom’, en bekijken hoe de index dit woord verwerkt. Configureer je Apache Solr niet met ondersteuning voor het Nederlands, dan bewaart hij alleen ‘chronischevermoeidheidssyndroom’ in de index. Zoekt iemand naar allerlei ‘syndromen’, dan verschijnt dit item niet in de resultaten van de website. Misschien verwacht je iets anders, maar zo slim is Apache Solr niet.

Wat je wel wilt

Is de index echter correct geconfigureerd, met ondersteuning voor Nederlandse woorden, dan geeft hij de volgende resultaten:
Het woord ‘Chronischevermoeidheidssyndroom’ wordt uiteindelijk zo geïndexeerd: ‘chronischevermoeidheidssyndroom’, ‘chronisch’, ‘scheve’, ‘vermoeid’, ‘syndroom’, ‘droom’, ‘room’. Zoekt iemand op een van deze woorden, dan wordt dit item als mogelijk resultaat gemarkeerd.

Zoeken we bijvoorbeeld op ‘Vermoeidheid’, dan mogen we verwachten dat ons geliefde ‘Chronischevermoeidheidssyndroom’ als resultaat verschijnt. Laten we dat uitproberen met de analysetool van Solr:


Uiteindelijk zoekt onze zoekopdracht naar items die geïndexeerd zijn met het woord ‘vermoeid’, en dat is ook een token in de index bij het indexeren van het woord 'Chronischevermoeidheidssyndroom'.

Kortom

Wanneer je een Solr-core opzet voor meertalige content, is het belangrijk om extra veldtypes te voorzien die de tekst in de juiste taal verwerken. Zo kan Solr het woord indexeren op een manier waarbij meervouden en samengestelde woorden begrepen worden. Dat geeft op zijn beurt een betere ervaring aan de gebruiker die een bepaald stuk content zoekt. Is alles correct geconfigureerd, dan krijgt een gebruiker die zoekt op ‘syndroom’ alle samengestelde woorden als mogelijk resultaat, en dus een beter overzicht van de content op je site.

Je vindt de resources van Dropsolid hier: https://gitlab.com/dropsolid/multilingual-solr-config